本地纯文本
每篇笔记就是电脑里一个真实的 .md 文件。就算 Obsidian 明天消失,VS Code、记事本照样能打开;AI 工具读写纯文本也非常容易。官网的标语是「Your knowledge should last」——你的知识应当持久。
TECH · 2026-09-09
收藏夹几百篇文章,期末写综述时一篇都想不起来——问题不在记性,在工具与流程。这篇指南从 Obsidian 的核心机制讲起,说清它与 Notion、Logseq、Roam、flomo 各自适合谁,再给出一条学生当天就能跑通的最小工作流。
先认领一个几乎人人都有过的体验:公众号文章、课程讲义、知乎回答、PDF 论文,看到觉得有用就收藏。三个月后写课程论文想引用,想不起标题、记不得关键词,搜索框里敲两下就放弃了。收藏夹越来越满,产出却不见涨——传统笔记最大的问题就在这:只进不出。你存的不是知识库,是一个没有索引、没有人整理的仓库。
2026 年 9 月,深耕 Obsidian 六年的博主 Jackywine 发了一篇长文,把自己收集的十几篇教程、深度研究与 AI 实操方案翻了个遍。这篇文章把其中对学生最有用的部分整理出来:工具怎么选、工作流怎么搭、AI 放在哪一层。原文信息量极大但偏个人叙事,下面的版本按「选型 → 机制 → 上手」重排,所有事实与数字以原文为准。
Obsidian 由 Shida Li 与 Erica Xu 于 2020 年新冠疫情隔离期间创建(两人此前做过大纲工具 Dynalist,2023 年 Minimal 主题设计师 Steph Ango 加入任 CEO)。团队只有约 7 人,做出了估值 3.5 亿美元、超过 150 万月活的产品,且从未接受外部融资。核心应用完全免费,只有同步($4/月)与发布($8/月)等增值服务收费——对学生而言,免费的部分恰好是全部核心功能。
它的两条底层设计值得先记住:
每篇笔记就是电脑里一个真实的 .md 文件。就算 Obsidian 明天消失,VS Code、记事本照样能打开;AI 工具读写纯文本也非常容易。官网的标语是「Your knowledge should last」——你的知识应当持久。
在笔记里写 [[另一篇笔记名]] 就建立了一条链接,对方页面会自动显示「谁提到了我」。文件夹只能告诉你笔记放在哪,链接还能告诉你它和什么有关——笔记越多,这张网越值钱。
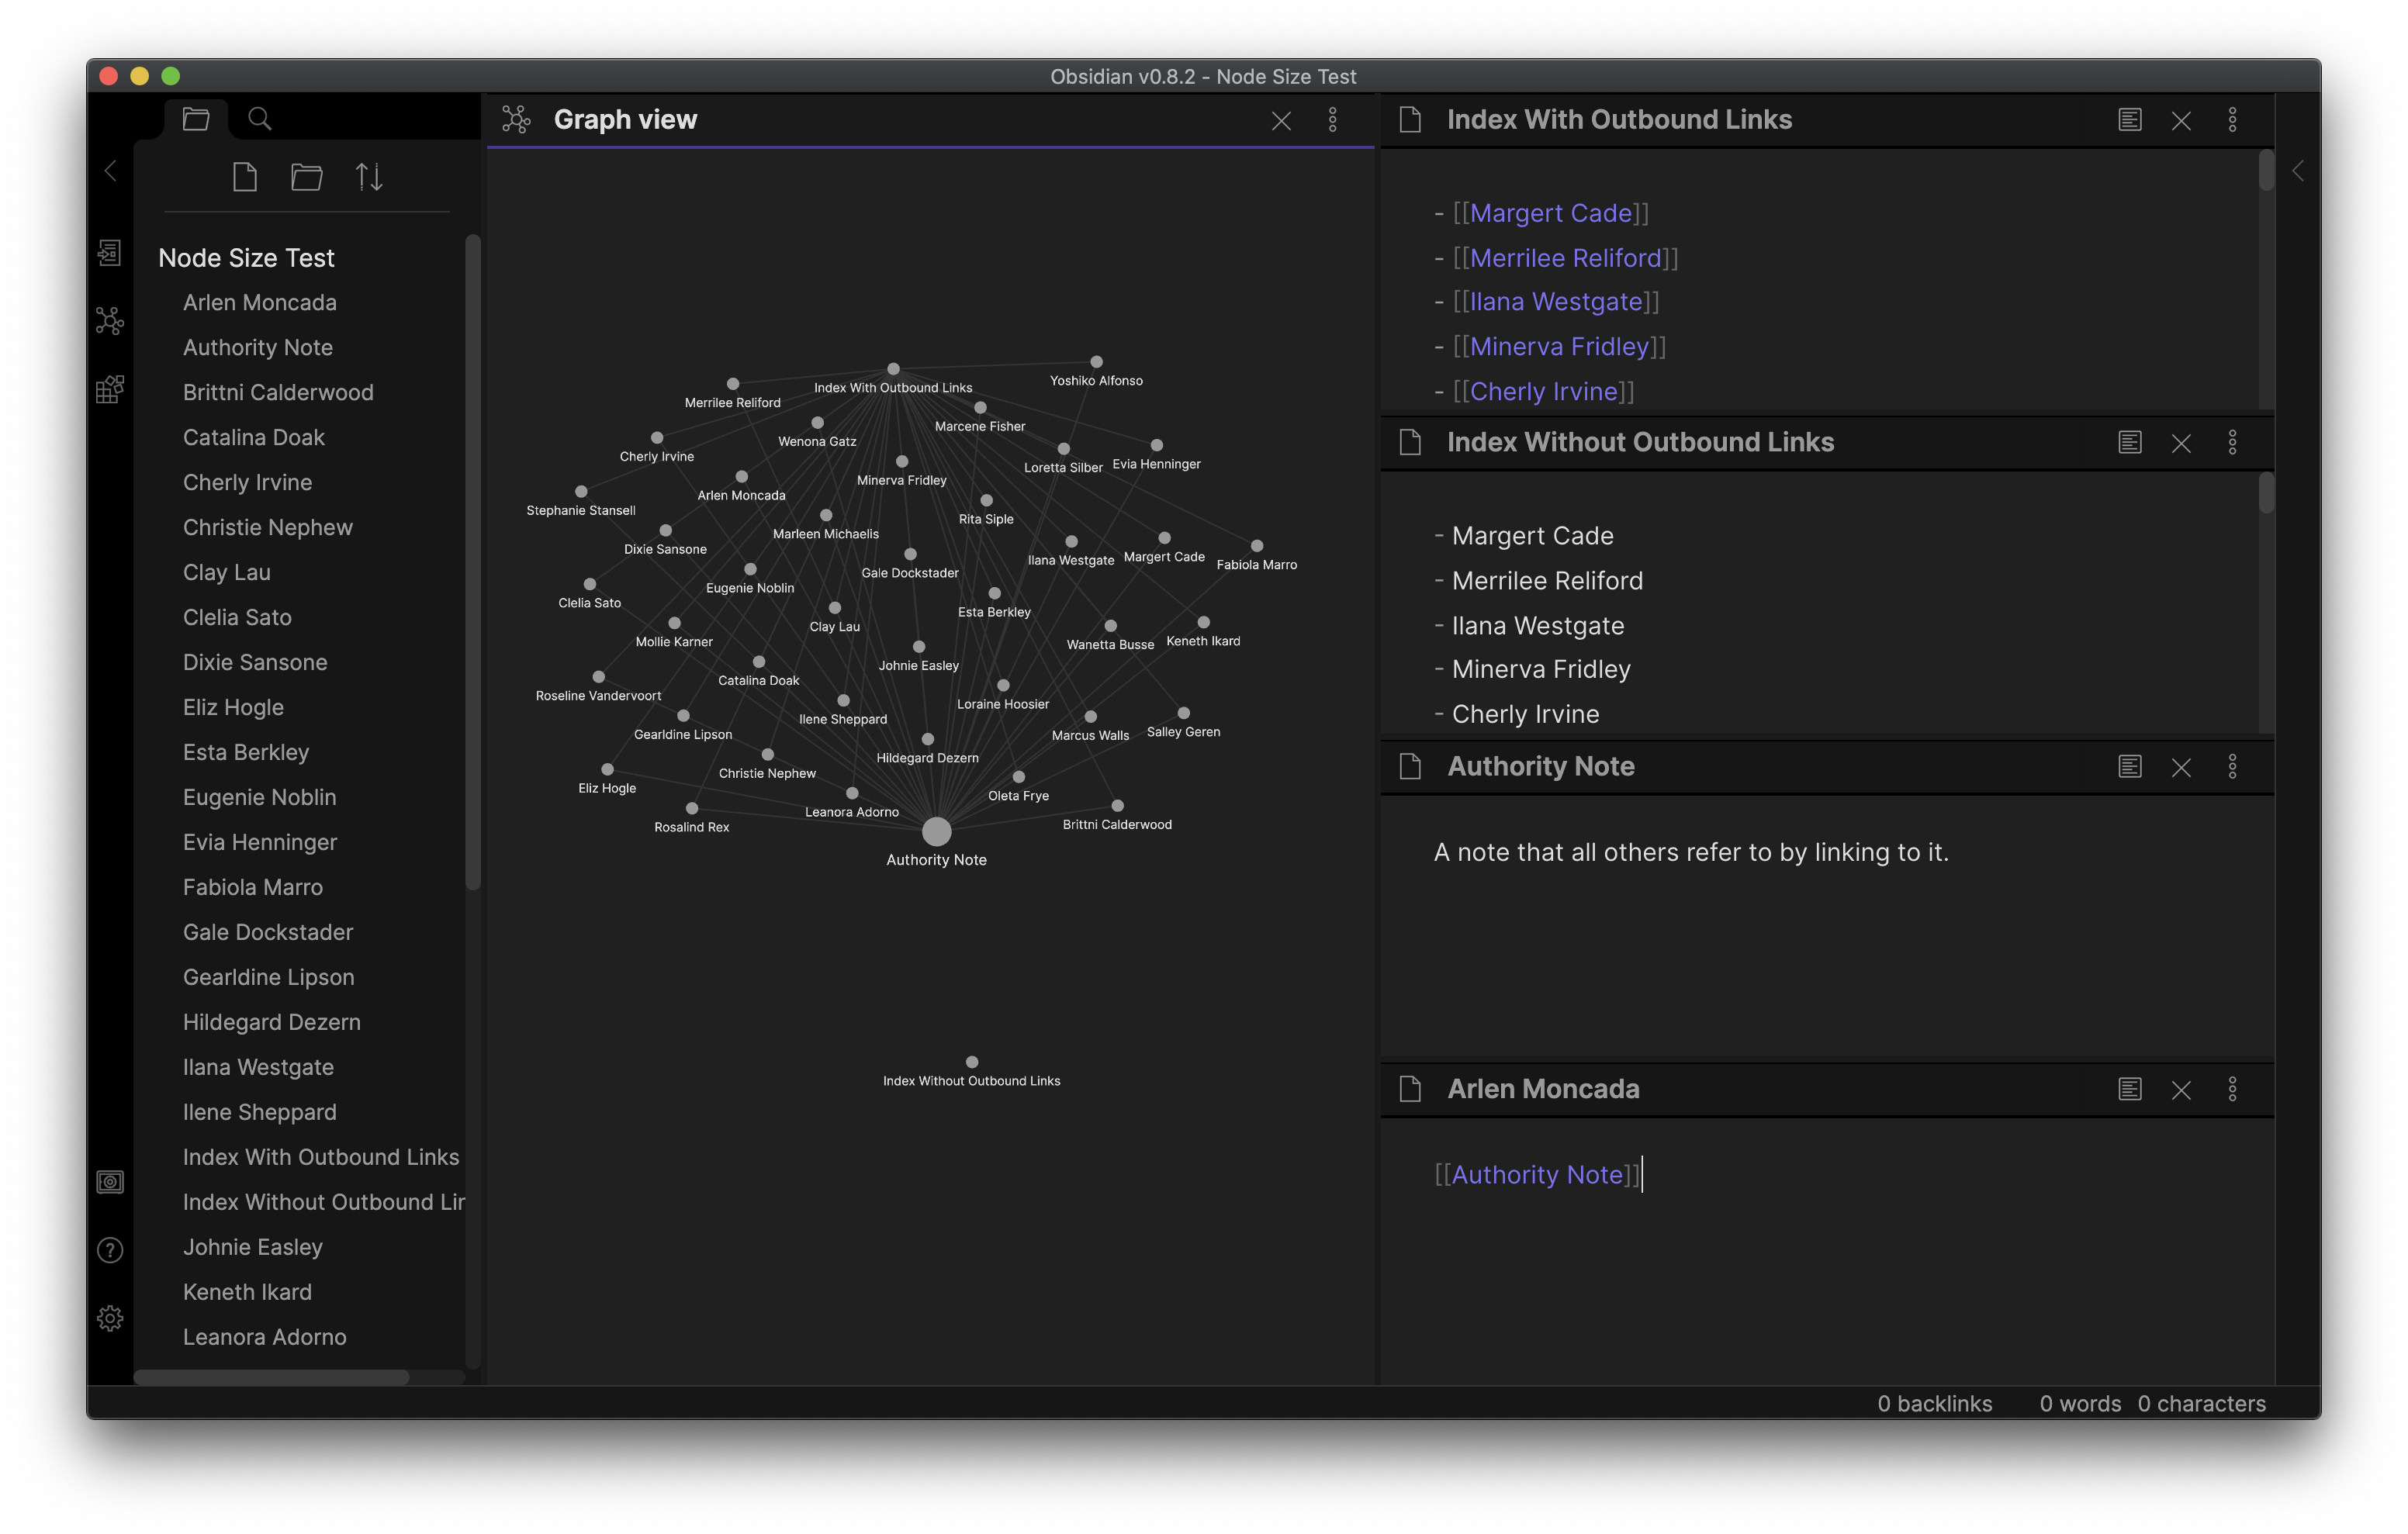
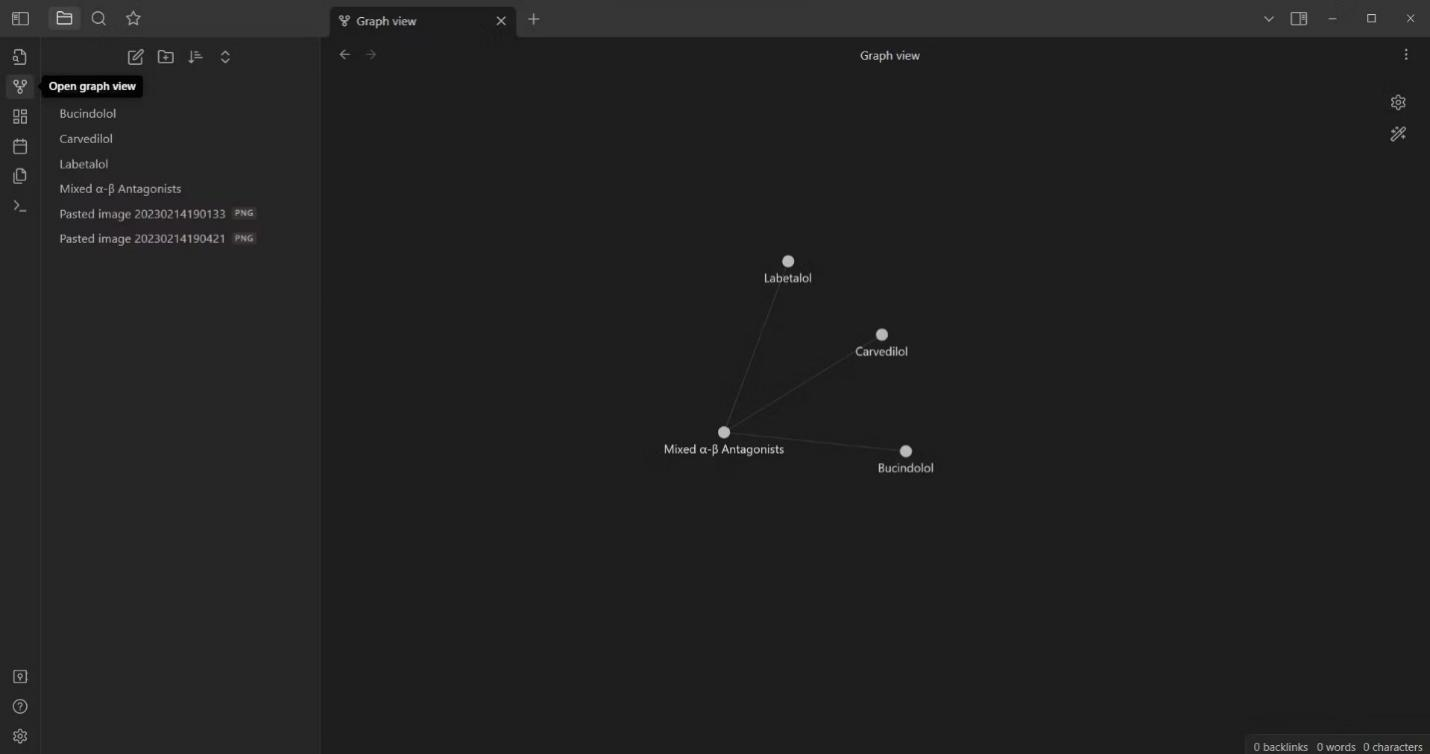
原文作者折腾六年的最大教训恰好相反:他装过 47 个插件,删库重建不下 10 遍,最后开了安全模式、第三方插件一个不装,只留最朴素的写、链、搜。社区里的自嘲是「I spent 3 hours configuring my productivity system instead of being productive」——花三小时配置系统,一个字没写。学生尤其容易踩这个坑。
原文引用的深度研究把几个主流工具的分工讲得很清楚。结论先给出:没有完美的笔记工具,只有适合你工作流的工具。对多数学生,推荐组合是「碎片用 flomo 或手机备忘录随手记,沉淀用 Obsidian」。
| 工具 | 存储与格式 | 强项 | 短板 | 适合谁 |
|---|---|---|---|---|
| Obsidian | 本地 Markdown 文件,免费 | 数据完全属于用户;双向链接与图谱;插件生态 2500+(2026 年 3 月数据) | 学习曲线较陡;基本不支持协作;无网页版 | 个人深度思考、长期知识积累 |
| Notion | 云端专有格式 | 团队协作与项目管理强;上手平缓;原生 AI($10/用户/月附加) | 数据在 Notion 服务器上;导出迁移成本高 | 小组作业、社团管理、协作场景 |
| Logseq | 本地优先、Markdown、开源免费 | 块级大纲:每个 bullet 是独立可引用单元;日记驱动工作流;碎片化捕获快 | 长文写作与结构化文档不如 Obsidian | 喜欢大纲体、以日记为主线记录的人 |
| Roam Research | 云端专有格式 | 2019–2020 年双链热潮的引爆者;块级引用粒度最细 | $15/月;云端存储;用户规模已被 Obsidian 反超 | 愿意付费的重度双链研究者 |
| flomo | 云端 | 最轻的收集站,走路时一句话就能记 | 不是知识库——原文称之为「数据湖」 | 所有人(作为入口,而非归宿) |
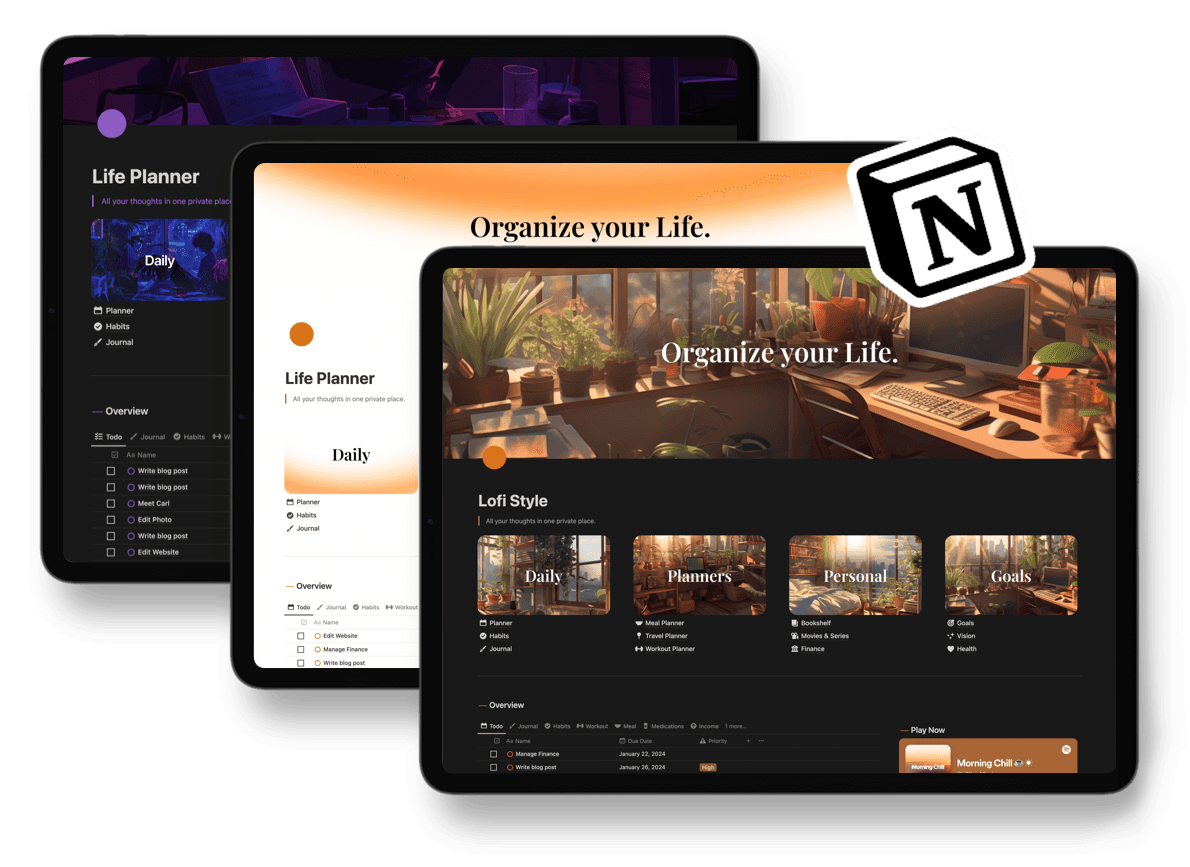
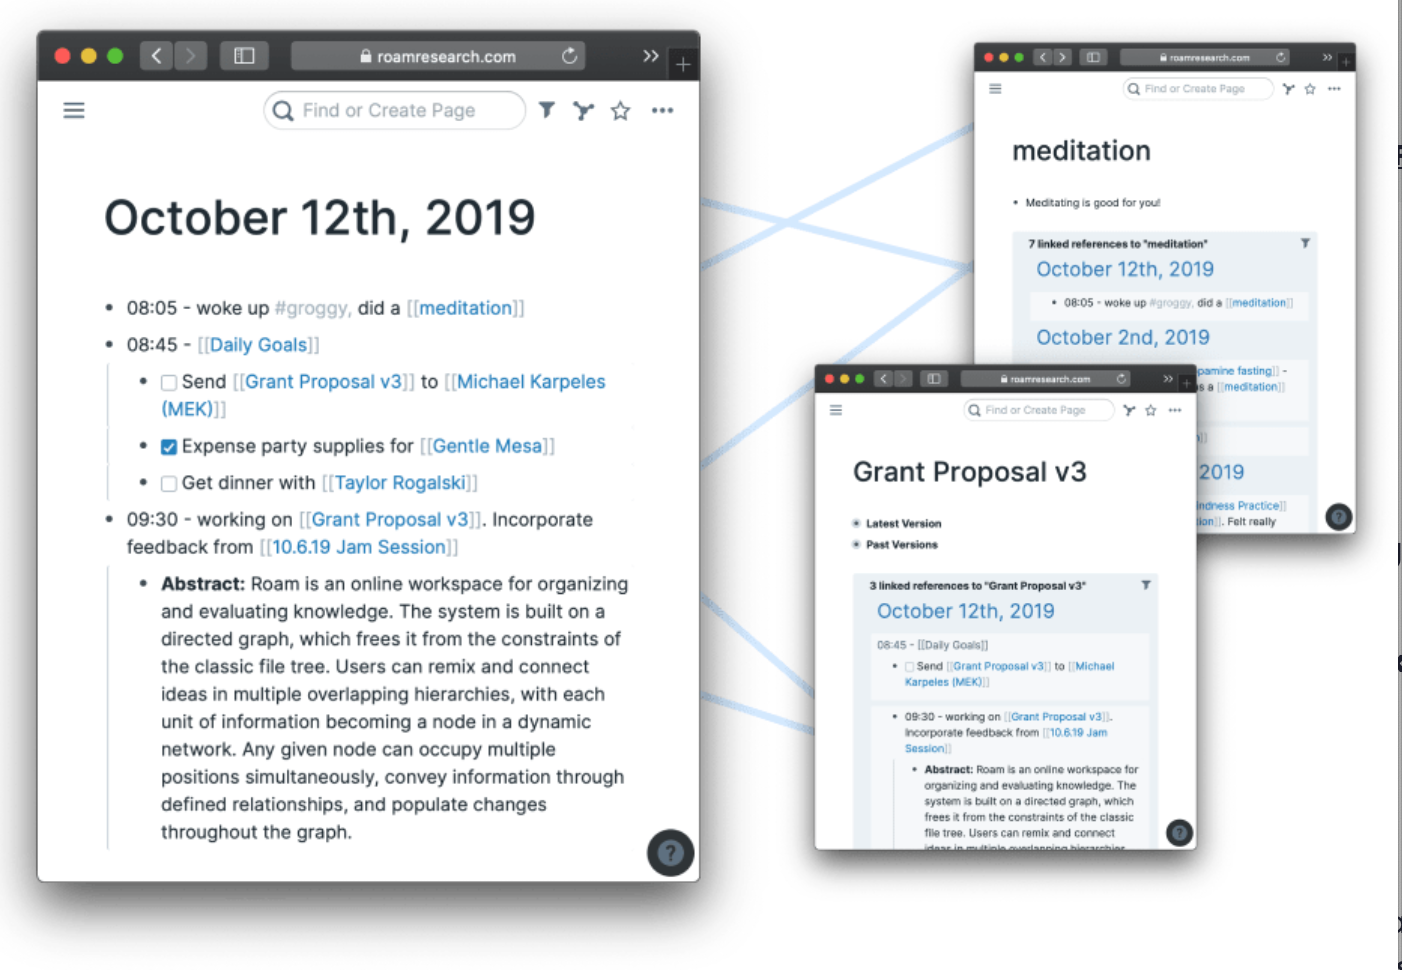
一句话记法:Notion 管协作,Logseq 管大纲,Roam 是贵一点的先驱,flomo 管收集,Obsidian 管沉淀。原文作者的说法是:他的系统里每层工具干每层的活,而 Obsidian 是常青笔记的最终归宿——那些经过捕获、经过思考打磨、值得长期保留的知识节点,最终落在 Vault 里。
这篇长文最有分量的部分,是对 Karpathy「LLM Knowledge Bases」工作流的转述。Karpathy(前特斯拉 AI 总监)发现,他现在大部分 token 消耗已经不在写代码,而在「操控知识」。他给了一个程序员秒懂的类比:Obsidian Vault 是代码仓库,LLM 是编译器——把原始资料「编译」成结构化知识。
| 软件工程 | 知识库工程 |
|---|---|
src/ 源代码 | raw/ 原始资料(剪藏文章、转录、笔记,只进不改) |
build/ 构建产物 | wiki/ 知识条目(摘要、概念、索引,由 LLM 维护) |
logs/ 运行日志 | outputs/ 问答归档(每次对知识库的复杂提问落成文件) |
| 增量编译 | 只处理新增的 raw,不每次全量重建 |
| Lint / CI 检查 | 定期健康检查:概念是否冲突、条目是否缺来源、是否有孤岛笔记 |
核心就三件事:分层(原始资料、编译产物、运行时输出分开,正如你不会把 .class 和 .java 混在一起);增量(每天新进几篇文章,编译增量就好);可追溯(每个知识条目能追到原始来源——不是「我好像在哪看过」,而是「来源在 raw/articles/ 那篇的第三段」)。
多数人用 AI 的方式是「问一个问题,得到答案,关掉」。下次遇到类似问题再问一遍,答案全埋在聊天记录里,等于没有。Karpathy 工作流里的改法:每次对知识库做复杂提问,把结果带问题、带时间、带来源、带不确定性存成 Markdown 文件,归档到 outputs/。三个月积累几十份,它们本身就是知识条目——你每跟 AI 聊一次,知识库就厚一层。
别一上来就搭 RAG。一提「AI + 笔记」,很多人的第一反应是选 Embedding 模型、搭向量数据库、调切片策略,整套架构搞一个月,库里只有 20 篇文章。Karpathy 的建议是:知识库在百篇、40 万词以内的规模时,维护几个索引文件就够——LLM 先读索引定位,再直接读原文,简单可靠、零额外成本。等真的过万条、搜不到了,再考虑 RAG。
Karpathy 的方案火起来后,Obsidian CEO Kepano 的回复可能是整场讨论里最值得记住的一句:
「Keep your personal vault clean and create a messy vault for your agents.」——保持你的个人库干净,给 AI 另建一个脏乱的库。
他的理由有四层:个人库要保持高信噪比,所有内容有已知来源;人写的产物与 agent 写的产物要分离,防止无法溯源的内容「污染」主库;如果混合太多,搜索、反链、图谱就不再只关于你的知识,而成了你和 AI 的混合物——那时分不清它是 AI 的知识库,还是你的;只有当 agent 的产出真正有用时,才经你筛选引入主库。
原文作者对此有切肤之痛:他让 AI 批量生成摘要、自动建链接、整理结构,三分钟干完三十分钟的活,直到某天打开库发现「我不认识这些东西了」——很整齐、很专业,但不是从自己脑子里长出来的,像小时候抄作业,写完了但没学会。他把这条教训记成一句话:「不要把思考外包」。判断哪个观点值得留、哪两个概念有隐秘联系,这种判断力来自日复一日亲手写、亲手链;这些全交给 AI,省下的不是时间,是思考本身。
落成操作就是「两库分离」:主库只放你一个字一个字写的常青笔记(Evergreen Notes,Andy Matuschak 提出:概念化、原子化、以链接组织);AI 的工作另开一个 Vault,它产出的洞察你认了,就用自己的话重写一遍再进主库——重写这个动作,就是内化。
obsidian.md 免费下载,新建一个库(它就是一个普通文件夹)。练习:新建一篇笔记、写一个标题、写一个列表、用 [[ ]] 建一个双链、看一眼反向链接面板。能做到,库和双链就都在正常工作。
第一个月只装一个 Web Clipper(浏览器剪藏插件),剪藏时让模板自动写入来源链接、作者、日期。没有元数据的剪藏等于没剪。其余 2500 个插件,等你真的遇到问题再加。
另建一个 Vault,按 raw/、wiki/、outputs/ 三层建目录,放一份规则文件(如 CLAUDE.md 或 AGENTS.md),写明:raw 只读不改、每个判断要指向来源、拿不准的标「待核验」。
把课程相关的文章剪藏进 raw,然后让 Claude 或 Codex 逐篇生成摘要、抽取概念、更新索引——用你写的规则文件约束它。第一次要半小时到一小时,之后增量编译很快。
写综述前对知识库提问,把带来源的回答存进 outputs/;每周让 AI 检查一次:概念有没有定义冲突、哪些条目缺来源、哪些笔记入链出链都少于 2(孤岛)。几周之后最大的感受是:搜到一条笔记,敢直接用了。
写到这里可以回答标题里的问题了:当获取、整理、生成信息的成本都趋近于零,稀缺的变成了判断力——知道什么值得留、什么该丢、两个概念之间有没有那条隐秘的连接。这种能力来自你亲手写的每一条笔记,AI 能帮你找到那两条记录,但「啊哈」的火花只能在你自己的神经元里点燃。原文的比喻很好:第二大脑不是仓库,是厨房——仓库只管存放,厨房才管创造,而厨房里站着的那个人只能是你。
加载中…