只用手工表格时的常见问题
复制粘贴容易错位;公式拖动后未必覆盖所有行;筛选条件容易忘记;图表改过一次以后,很难说明最终结果来自哪一步。数据一更新,许多操作要从头再做。
Python在金融中的应用 · 第一部分
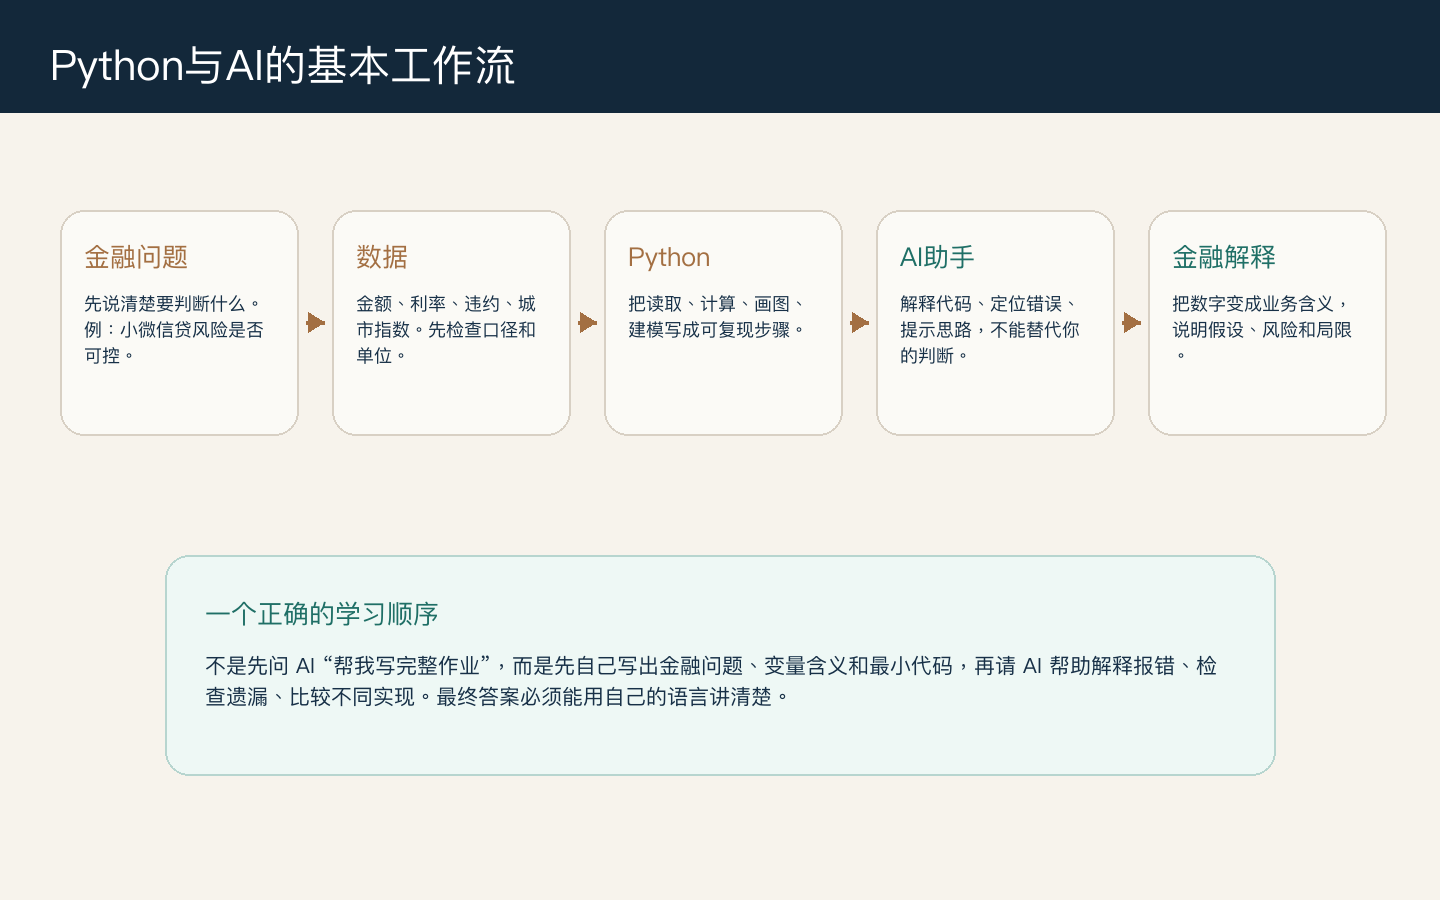
需要先建立一个关键认知:Python 是把金融问题变成可计算步骤的工具,人工智能是帮助理解、检查和改进这些步骤的伴学工具。AI 可以提高学习效率,但不能代替你理解金融问题、检查数据口径、解释模型结果。
学习这门课时,建议把每一次代码运行都看成一次“金融分析流程”的训练:问题是否清楚,数据是否可靠,计算是否正确,解释是否稳妥。
金融问题经常不是一道孤立的计算题,而是一组连续任务:收集数据、整理变量、计算指标、画图比较、估计模型、解释结果。只要数据稍微复杂一点,完全依靠手工操作就容易出错,也很难复现。
复制粘贴容易错位;公式拖动后未必覆盖所有行;筛选条件容易忘记;图表改过一次以后,很难说明最终结果来自哪一步。数据一更新,许多操作要从头再做。
读取数据、筛选样本、计算指标、绘图和建模可以写成一套清楚的步骤。只要代码和原始数据保存下来,别人可以检查,你自己也可以在以后复现结果。
例如,研究“一个城市的普惠金融水平是否改善”时,不能只看某一年的一个分数。更合理的做法是读取多个年份的城市指数,检查城市名称和年份是否一致,计算变化幅度,画出趋势图,再结合地区经济背景进行解释。Python 能帮助你把这些步骤写清楚。
再如,分析小微信贷时,不能只看“贷款利息收入”。还要考虑违约概率、违约损失率、客户现金流稳定性、行业周期和授信规模。Python 的作用是把这些因素变成可计算、可比较的指标;但指标是否合理,需要金融知识来判断。
很多初学者会把 Python、人工智能、机器学习、ChatGPT、Trae、Cursor 混在一起。分清它们的角色,后面学习会更稳。
| 概念 | 可以怎样理解 | 在本课程中的作用 | 不能替代什么 |
|---|---|---|---|
| Python | 一种编程语言,用来明确告诉计算机每一步怎样做。 | 读取数据、计算指标、画图、建模、输出结果。 | 不能自动判断金融问题是否问得对。 |
| 人工智能 | 一类让计算机完成理解、生成、预测或辅助决策的方法。 | 辅助解释代码、修正报错、生成初稿、提示遗漏。 | 不能保证答案一定正确,也不能替你承担学术责任。 |
| 机器学习 | 从数据中学习规律,再用于预测、分类或识别模式。 | 违约预测、客户分群、风险识别、文本分类。 | 不能自动解决样本偏误、变量遗漏和因果解释问题。 |
| 大语言模型 | 能够理解和生成自然语言,也能辅助写代码的 AI 模型。 | 解释概念、帮助调试、把复杂代码拆成可读步骤。 | 不能替代真实数据检查和结果复核。 |
| AI 编程工具 | 把 AI 接入写代码的软件,使 AI 能读当前项目和代码。 | 后续会以 Trae 为例,学习创建项目、运行代码、修正错误。 | 不能替代你理解变量、路径、环境和输出结果。 |
一个实用原则:Python 负责“把步骤执行出来”,AI 负责“帮助理解和改进步骤”,你负责“提出问题、判断假设、解释结果、承担责任”。
把 AI 当作“伴学工具”,不是把作业扔给它。可以用学开车来理解:教练可以提醒你哪里操作错了,也可以示范一次,但方向盘最终要由你自己控制。如果每次都让教练替你开,短期看似省力,长期一定学不会。
直接输入“帮我完成这道题”“帮我写完整代码”“帮我生成作业答案”。这种方式的问题是:你可能得到一个能运行的结果,但不知道变量为什么这样设定,也不知道结果是否合理。
先自己写出问题、变量和初步代码;运行后把错误、困惑或不理解的地方交给 AI;要求 AI 解释原因、给出最小修改、指出需要复核的金融含义。这样才是在提高自己的能力。
学习中可以经常问自己三个问题:第一,我是否能不用 AI 说清楚题目要解决什么金融问题;第二,我是否能解释代码中每个变量的含义;第三,AI 给出答案后,我是否能判断答案哪里可能不可靠。如果三个问题都答不上来,就说明 AI 已经从“伴学”变成了“替学”。
先看一个很小的例子。假设有一笔小微信贷:贷款金额 10 万元,年利率 6%,预计违约概率 8%,违约后的损失比例 45%。现在要计算利息收入、预期损失和预期收益。
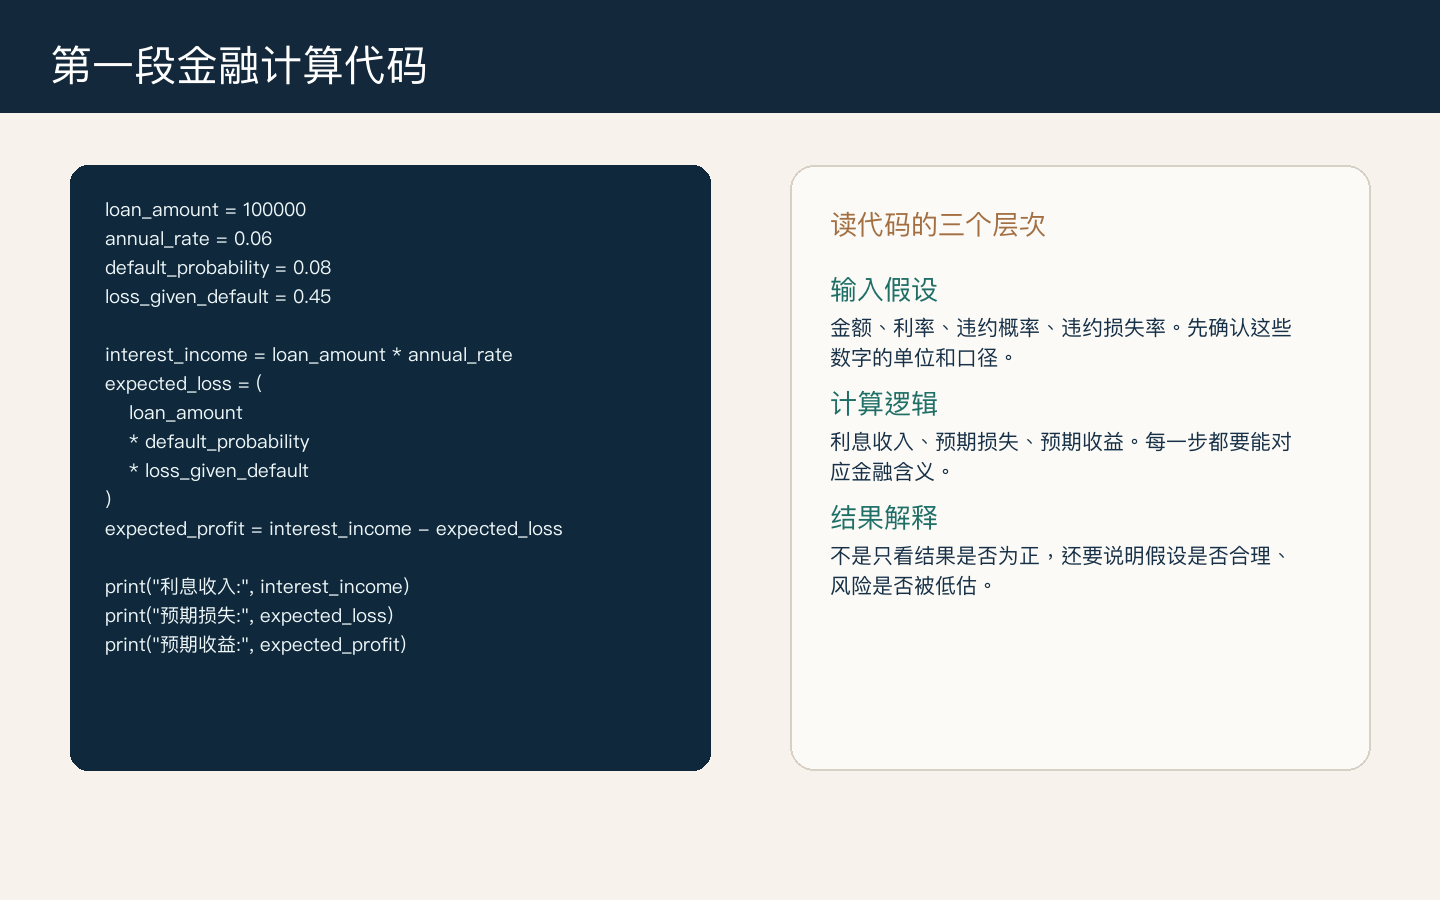
# 一个小微信贷的最简单计算例子
loan_amount = 100000       # 贷款金额:100000 元
annual_rate = 0.06         # 年利率:6%
default_probability = 0.08 # 预计违约概率:8%
loss_given_default = 0.45  # 违约后的损失比例:45%

interest_income = loan_amount * annual_rate
expected_loss = loan_amount * default_probability * loss_given_default
expected_profit = interest_income - expected_loss

print("利息收入:", interest_income)
print("预期损失:", expected_loss)
print("预期收益:", expected_profit)| 变量名 | 金融含义 | 当前取值 | 需要检查的问题 |
|---|---|---|---|
loan_amount | 贷款本金 | 100000 | 单位是元、万元还是其他口径? |
annual_rate | 年利率 | 0.06 | 是名义利率还是实际利率?是否已经年化? |
default_probability | 预计违约概率 | 0.08 | 来自历史数据、模型预测,还是主观估计? |
loss_given_default | 违约后的损失比例 | 0.45 | 是否考虑抵押、担保、催收和处置成本? |
expected_profit | 风险调整后的预期收益 | 计算得到 | 是否足以覆盖运营成本和资金成本? |
读代码时,不要只问“这段代码怎么写”。更重要的问题是:“这个变量对应什么金融含义?”“这个公式对应什么经济逻辑?”“这个结果是否在合理范围内?”
金融分析经常要问“如果假设变了,结果会怎样”。例如,违约概率从 8% 上升到 12%,预期收益会发生什么变化?这就是最简单的敏感性分析。
# 比较不同违约概率下的预期收益
loan_amount = 100000
annual_rate = 0.06
loss_given_default = 0.45

for default_probability in [0.04, 0.08, 0.12, 0.16]:
    interest_income = loan_amount * annual_rate
    expected_loss = loan_amount * default_probability * loss_given_default
    expected_profit = interest_income - expected_loss
print(default_probability, expected_profit)这段代码引入了一个新的结构:for 循环。它的意思是:让违约概率依次取 4%、8%、12%、16%,每取一次就重新计算预期收益。这样可以看到结果对违约概率有多敏感。
如果违约概率较低,利息收入可能足以覆盖预期损失,预期收益为正。
如果违约概率上升,预期收益会被压缩。此时需要关注客户筛选和授信额度。
如果违约概率过高,贷款可能不再具备风险调整后的收益,需要重新评估。
这个例子也说明了 Python 的一个重要价值:当你需要重复计算多种情景时,不必手工复制公式,而是让代码完成重复工作。人的精力应该放在解释结果和判断假设上。
AI 对初学者很有帮助,但也最容易让初学者产生“我会了”的错觉。看到 AI 生成了一段代码,并不等于已经掌握。真正掌握至少包括三件事:能解释代码每一行的作用,能发现结果是否异常,能在题目稍微变化后自己修改。
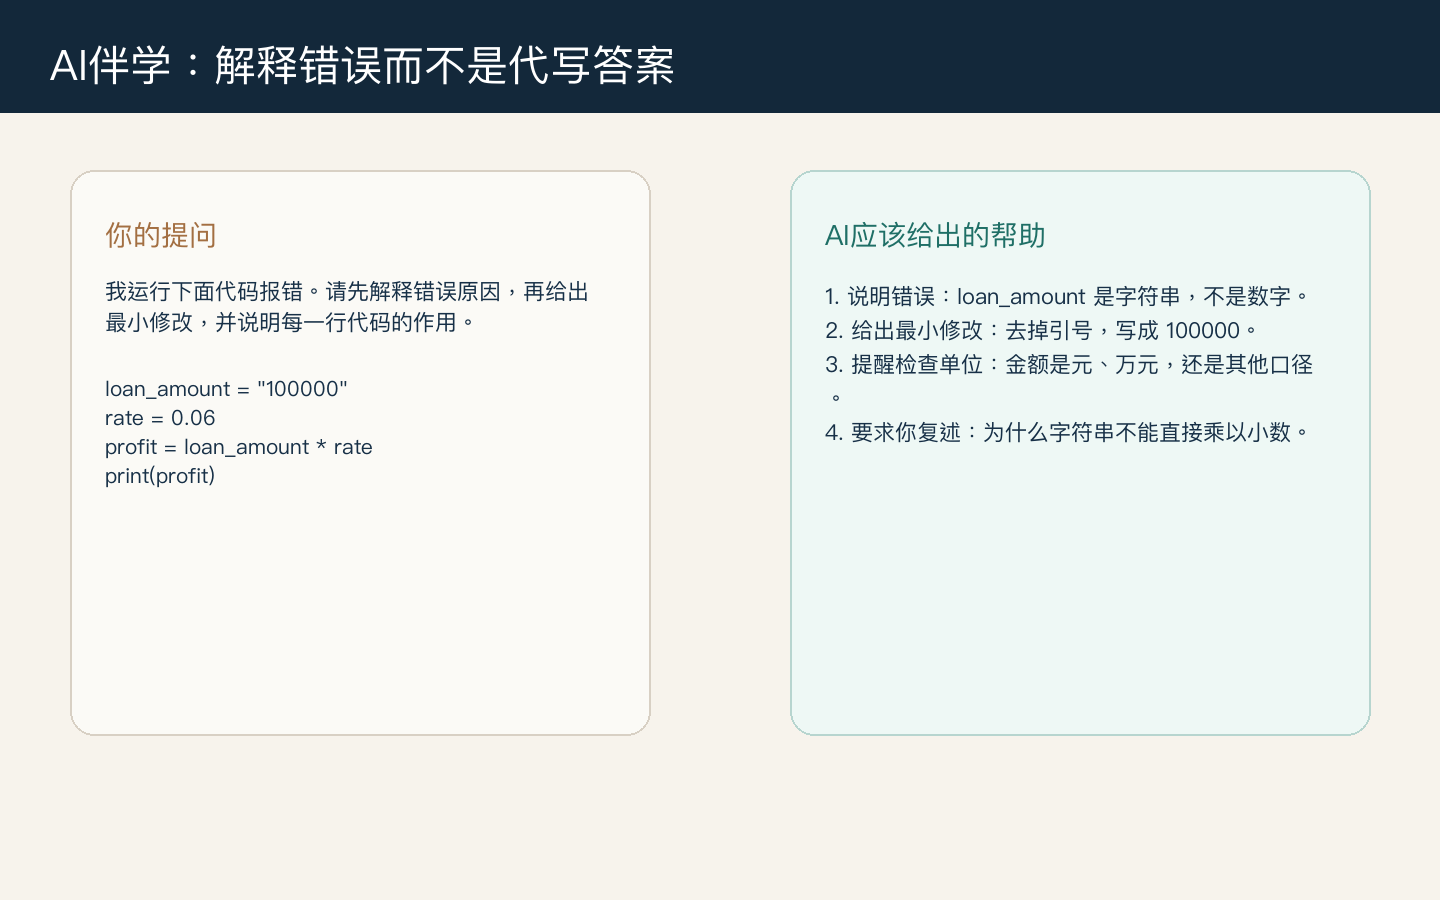
底线很清楚:AI 可以帮助定位错误、解释概念、提供示例,但不能替你完成理解。不能用 AI 偷懒来绕过学习过程。短期省掉的努力,会在后续数据处理、建模和论文写作中变成更大的困难。
AI 回答质量很大程度上取决于提问质量。对于代码问题,至少要提供四类信息:目标、代码、报错、你自己的理解。只有这样,AI 才更可能给出可用于学习的回答。
| 需要提供的信息 | 为什么重要 | 例子 |
|---|---|---|
| 目标 | 让 AI 知道你想完成什么金融任务。 | 我想计算一笔小微信贷的预期收益。 |
| 代码 | 让 AI 能看到完整上下文。 | 粘贴当前运行的代码,而不是只说“运行不了”。 |
| 报错 | 报错信息通常直接指出问题位置和类型。 | 复制完整报错,不要只复制最后一个词。 |
| 你的理解 | 让 AI 知道你卡在哪里,也能帮助你检验自己的理解。 | 我猜是变量类型不对,但不确定字符串和数字有什么区别。 |
我正在学习 Python 在金融中的应用。
我的目标是:(用一句话写清楚金融任务)

下面是我的代码:
(粘贴代码)

运行后的报错或异常结果是:
(粘贴完整报错,或者说明结果为什么奇怪)

我目前的理解是:
(写出你认为可能的问题)

请按以下顺序回答:
1. 用通俗语言解释错误原因;
2. 只给最小修改,不要重写无关代码;
3. 逐行解释修改后的代码;
4. 提醒我需要检查的金融含义、单位和假设;
5. 给我一个类似的小练习,让我自己再做一遍。
这个模板的关键不是“让 AI 回答更长”,而是强迫自己参与学习过程。只要你写出了目标、代码、报错和自己的理解,就已经完成了一半学习。
后续学习不要一开始就追求复杂模型。更稳妥的顺序是:先能整理数据,再能计算指标,再能画图表达,最后进入预测模型和因果分析。基础不牢,模型越复杂,错误越隐蔽。
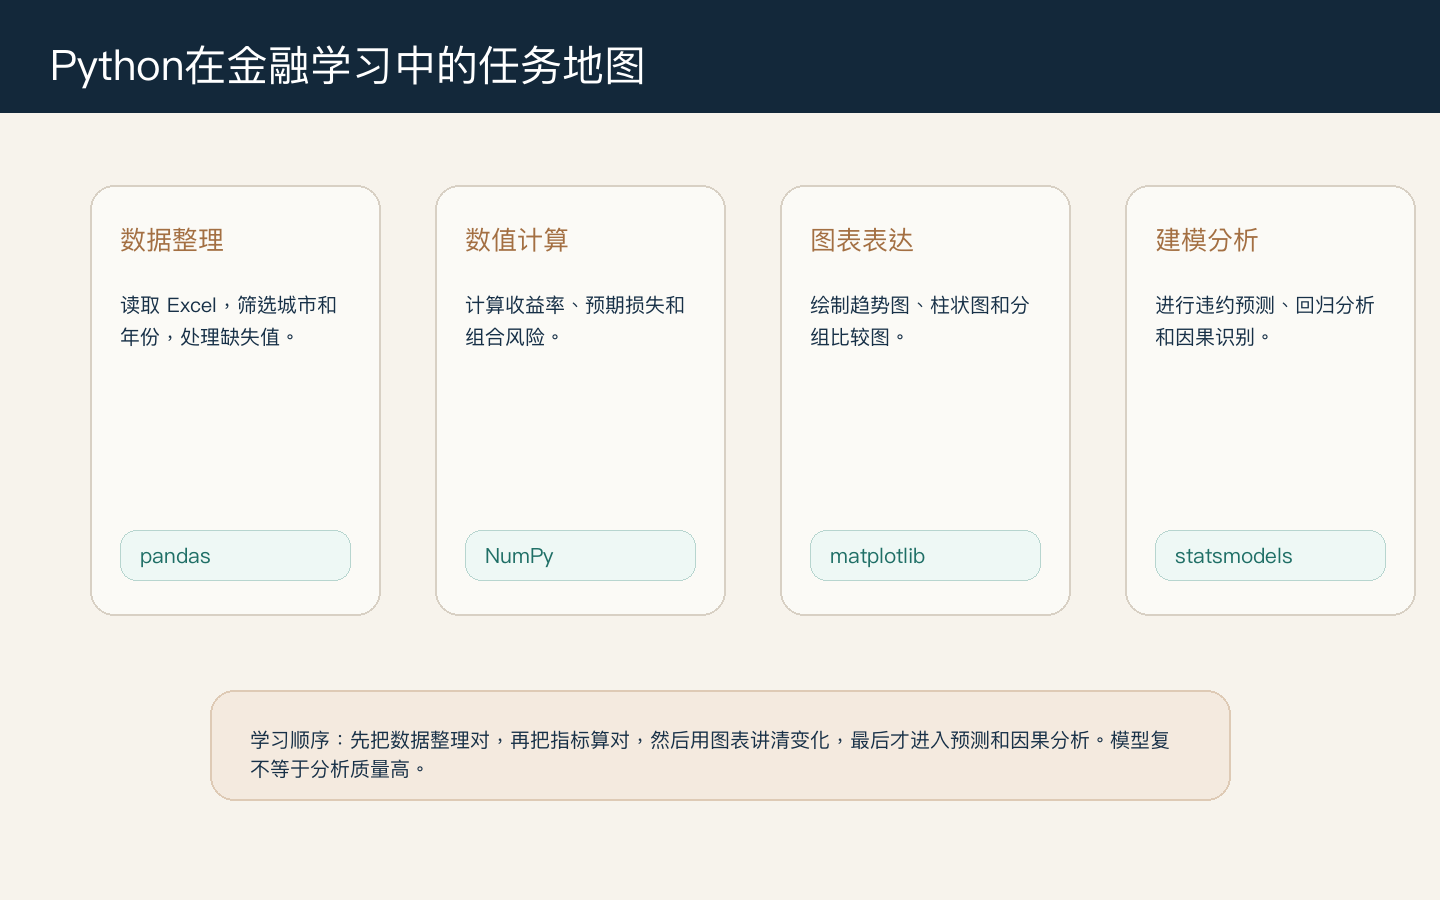
| 任务 | 例子 | 常用工具 | 后续课程位置 |
|---|---|---|---|
| 数据整理 | 读取城市普惠金融指数 Excel,筛选 2023 年杭州、上海、北京等城市。 | pandas | 第二部分 Pandas |
| 数值计算 | 计算小微信贷组合的平均利率、预期损失、风险调整收益。 | NumPy | 第二部分 NumPy |
| 图表表达 | 画出 2015—2023 年城市普惠金融指数变化趋势。 | matplotlib, seaborn | 第二部分绘图 |
| 建模分析 | 分析普惠金融指数提高是否与小微企业活跃度提升有关。 | statsmodels, linearmodels | 第三部分因果分析 |
在这个顺序中,数据整理最容易被低估。很多模型结果出错,并不是因为模型本身复杂,而是因为前面的数据合并、变量单位、缺失值处理或样本筛选出现了问题。
假设要分析“某城市普惠金融服务是否改善了小微商户融资便利性”。这个问题听起来简单,但至少包含四个层次。
在这个场景中,AI 可以帮助解释“融资便利性可以怎样度量”,可以帮你生成读取 Excel 的代码,也可以帮你检查报错。但是变量定义是否合理、因果解释是否成立、结论是否过度,都必须由你自己判断。
下面的练习不要求马上安装环境。目标是训练思考方式。可以把答案写在纸上,或者先保存到笔记中。
用自己的话解释下面三个变量分别代表什么:loan_amount、default_probability、loss_given_default。要求不要只翻译英文变量名,而要解释它们在小微信贷风险分析中的作用。
如果违约概率从 8% 上升到 15%,你预计预期收益会上升还是下降?为什么?先用文字解释,再尝试修改代码中的一个数字。
让 AI 解释这段代码后,检查它是否说明了单位、变量含义和金融假设。如果 AI 只解释了 Python 语法,没有解释金融含义,继续追问。
把“帮我写代码”改写成一个更好的问题。问题中必须包含目标、变量、你已经尝试的代码,以及你希望 AI 如何帮助你。
这一节只是入口,目的不是马上掌握所有 Python 语法,而是先形成正确的学习方式:先理解金融问题,再使用 Python 表达计算步骤,再让 AI 帮助检查和解释。后面的内容会按照“工具准备—数据分析与数据库—金融应用—事件驱动分析智能体”的顺序展开。
围绕“怎样开始写 Python”展开,重点建立从问题到代码的基本工作流。
围绕“怎样处理金融数据”展开,从数组、表格、图表逐步进入数据库。
围绕“怎样把 Python 用到金融问题中”展开,强调可复现、可解释的完整分析过程。
围绕“怎样把数据、模型与安全边界组织成可复现的智能体流程”展开。重点不在让 AI 替你做判断,而在于让每一步输入、请求、输出和限制都能被检查。
context 文本:保留数据截止日、来源、价格口径与缺失信息,再作为模型的唯一事实输入。学习要求也很明确:每次写代码前,先写清楚金融问题和变量含义;每次运行代码后,检查单位、样本、结果范围和图表表达;每次使用 AI 后,用自己的话复述它的解释,并判断它有没有忽略金融含义。不能复制自己看不懂的代码,也不能把 AI 输出直接当成最终答案。
下一节会进入 IDE 的选择、安装、写代码与调试。到那时会以 Trae 为例,从下载安装到创建项目、运行第一段代码、使用 AI 定位错误开始,一步一步完成。